
2026华东杯B题 — 医药物流派车调度与时空聚类优化
第二十八届华东杯大学生数学建模邀请赛 B 题(Team B35)。本文针对医药物流企业的派车调度与运单聚类问题,构建了"数据清洗 → 全成本建模 → 时空聚类 → ALNS 自适应大邻域搜索"的四阶段求解体系。核心创新:ST-DBSCAN + ALNS 混合算法在 18.5 万运单、5 维多目标约束下,综合得分提升 75%,装载率从 21.7% 提升至 50.5%。
一、问题重述与分析
1.1 问题背景
某医药物流企业总部位于南通市崇川区,承担药品从多个仓库到各级医院的冷链运输任务。企业运营三种型号车队(4.2M / 7.6M / 9.6M),积累了三个自然月(2018 年 8 月—11 月)的运营数据:
- 派车单数据(~1,000 条):包含车型、路线顺序、预计到货时间、托盘数
- 运单数据(~185,000 条):包含物流单号、收货地址、温度类型、容积当量、调度时间
运单温度类型覆盖:冷链、常温、贵冷、贵重、麻精,其中冷链药品对运输车辆的温度属性有严格匹配要求。
当前痛点:派车方案存在装载率低、车辆数与货物量不匹配、温度属性混装等问题,亟需系统性的优化建模。
1.2 三个子问题
| 问题 | 任务描述 | 数据规模 | 核心方法 |
|---|---|---|---|
| 问题一 | 核算当前固定方案的运输成本,分析成本结构 | ~1,000 条 | 全成本模型 + 高德 API 距离矩阵 |
| 问题二 | 基于时空特征优化派车方案,降低成本 | ~1,000 条 | ST-DBSCAN + 熵权法 + 模拟退火 |
| 问题三 | 对全量运单进行聚类分析,优化调度方案 | ~185,000 条 | ST-DBSCAN (cKDTree 加速) + AHP + ALNS |
1.3 关键假设
| 编号 | 假设 | 依据 |
|---|---|---|
| A1 | 两地间最短运输时间不随出发时段变化 | 高德 API 返回的是典型交通状况下的均值 |
| A2 | 车辆在出发日 9:00 前完成装车,9:00 准时出发 | 行业惯例 |
| A3 | 下午 15:00 后到达需等待至次日(装货需 2h,17:00 结束作业) | 物流行业实操约束 |
| A4 | 同型号车辆性能、油耗在不同路段保持一致 | 标准化假设 |
| A5 | 所有订单在预计到货日期前一周已知且不更改 | 计划调度场景 |
| A6 | 车辆完成配送任务后返回出发仓库 | 闭环路径 |
二、数据预处理
2.1 地址清洗
原始运单地址包含大量噪声:收件人姓名、手机号、派送路由码、楼栋楼层号等。构建多规则分层匹配清洗体系:
| 规则 | 正则/策略 | 示例 |
|---|---|---|
| 姓名 + 电话剥离 | re.sub(r'/[一-鿿]{2,4}/\d{5,}.*', '', addr) |
赵州镇工业街/张蒙/15354… → 赵州镇工业街 |
| 路由码去除 | 匹配 E3|N5|W1|[POS] 等前缀 |
E3北京市顺义区… → 北京市顺义区… |
$ 分隔符处理 |
取后半段正式场所名 | 洪洞广胜寺(坊堆村杨智俊)$洪洞县广胜寺镇中心卫生院 |
| 楼层室号截断 | re.sub(r'\d+[幢号楼]\d+[单元层]\d+室?', '', addr) |
南京市来凤路23号百利华府6幢116室 → 南京市来凤路23号 |
| 中文括号清洗 | 去除 ()、【】 及内部标注 |
北京市朝阳区(原崇文区)… → 北京市朝阳区… |
| 短地址挂靠 | 无省市信息的短地名 → 挂靠至仓库所在城市 | 骨二科 → 南通市崇川区 + 骨二科 |
清洗后得到 30,060 个有效地址(从 33,841 个去重地址中),无效地址标记为 COORD-FETCH-FAILED 并剔除。
2.2 地理编码与距离矩阵
调用高德地图 Web API 分两步完成:
- 地理编码:对清洗后地址批量请求经纬度。针对同名城市歧义 → 先正则提取行政区 → API 获取 adcode → 限定城市范围反查。
- 驾车导航距离:构建 和 的完整距离/时间矩阵。
将所有坐标缓存至 geocode_cache.json(约 8,630 条记录),避免重复 API 调用。
2.3 车型与托盘标准化
运单中的车型描述(如"金杯""箱货""4.2米")缺乏统一标准。建立车型 → 标准长度 → 托盘数映射表:
1 | # chexing_map.py — 车型标准化映射 |
同时处理托盘 ↔ 箱 ↔ 件的单位换算(基于企业提供的换算表)。
三、问题一:全成本核算模型
3.1 成本构成
单次派车的总成本由四部分组成:
3.1.1 月均固定成本
依据广西交通运输厅标准文件,车辆月度固定成本包括折旧、保险、维保等:
3.1.2 人工日成本
在途天数 = 实际到货日期 实际提货日期,返程天数 = 从最后一个送货点返回仓库的行驶时间(取 ceil)。周末等待期照常计算人工。
3.1.3 里程成本
其中 从高德 API 距离矩阵直接查表, 为油耗 + 路桥费之和。
3.1.4 车辆数确定
3.2 车型成本参数
| 参数 | 4.2M | 7.6M | 9.6M |
|---|---|---|---|
| 月固定成本 (元) | 11,272 | 14,183 | 15,399 |
| 每公里变动 (元/km) | 1.70 | 2.40 | 3.00 |
| 每日人工 (元/天) | 600 | 600 | 800 |
| 最大托盘数 | 5 | 11 | 14 |
| 最大里程 (km) | 300 | 3,500 | 4,500 |
| 年总成本 (元) | 515,263 | 620,199 | 694,786 |
| 单位托盘成本 (元/托·km) | 1.03 | 0.56 | 0.50 |
3.3 核算结果
| 月份 | 4.2M (辆) | 7.6M (辆) | 9.6M (辆) | 总成本 (万元) |
|---|---|---|---|---|
| 第1月 | 0 | 30 | 7 | 106.5 |
| 第2月 | 0 | 141 | 2 | 368.2 |
| 第3月 | 0 | 192 | 10 | 516.5 |
问题诊断:① 4.2M 小型车未被使用,"大车拉小货"浪费装载空间;② 里程成本与人工成本合计占比超 70%,是优化的主要发力点;③ 第2、3月需求量激增,但车辆配置未同步优化。
四、问题二:派车方案优化
4.1 派车单时空聚类 (ST-DBSCAN)
在优化之前,先对派车单进行时空聚类,识别具有"协同配送潜力"的订单群体。
样本特征向量:
其中 为收货地址经纬度, 为到货天数(相对于最早日期的偏移)。
时空邻域定义:
空间距离采用 Haversine 公式计算球面距离:
核心点判定:若 ,则 为核心点,与其邻域内所有点构成一个聚类簇。
参数设置: km, 周,(派车单数据量小,空间跨度大)。
4.2 熵权法车型选择
模拟退火的邻域变换中需要确定换车策略的概率。采用熵权法计算三种车型的综合得分,转化为选车概率。
步骤 1:构建决策矩阵(年总成本、单位托盘成本、托盘容量、变动成本):
| 车型 | 年总成本 (万) | 单位托盘成本 (元/托·km) | 托盘容量 | 变动成本 (万/年) |
|---|---|---|---|---|
| 4.2M | 51.53 | 1.0305 | 5 | 38.0 |
| 7.6M | 62.02 | 0.5638 | 11 | 45.0 |
| 9.6M | 69.48 | 0.4963 | 14 | 51.0 |
步骤 2:计算各指标的信息熵 和熵权 :
步骤 3:熵权结合 softmax 得到选车概率:
| 车型 | 固定成本熵权 | 变动成本熵权 | 托盘容量熵权 | 综合得分 | softmax 概率 |
|---|---|---|---|---|---|
| 4.2M | — | — | — | 0.5545 | 39.3% |
| 7.6M | — | — | — | 0.5478 | 38.0% |
| 9.6M | — | — | — | 0.4455 | 22.8% |
熵值越小 → 指标区分度越高 → 权重越大。固定成本指标的三车差异最大,权重最高(30.1%)。
4.3 模拟退火联合优化
以 ST-DBSCAN 聚类结果作为初始解,对每个簇独立运行模拟退火。
状态编码:解向量 ,其中 为车型, 为配送顺序列表, 为该线路所有预计到货日期的 。
邻域变换(等概率执行以下三种之一):
- 同车换序(70%):随机选一车,交换其中两个订单的配送顺序
- 跨车挪单(30%):从一车移除一个订单,随机插入另一车的某位置
- 随机换车:每次操作后以熵权概率重新采样车型
退火参数:
接受准则:若 则直接接受;否则以 概率接受劣解。
4.4 优化结果
| 月份 | 旧方案总成本 | 新方案总成本 | 优化幅度 | 新增 4.2M 车数 |
|---|---|---|---|---|
| 第1月 | 1,065,210 | 785,143 | -26.3% | 1 → 替代部分 7.6M |
| 第2月 | 3,681,908 | 2,814,889 | -23.5% | 22 → 短途分流 |
| 第3月 | 5,165,180 | 4,110,972 | -20.4% | 22 → 短途分流 |
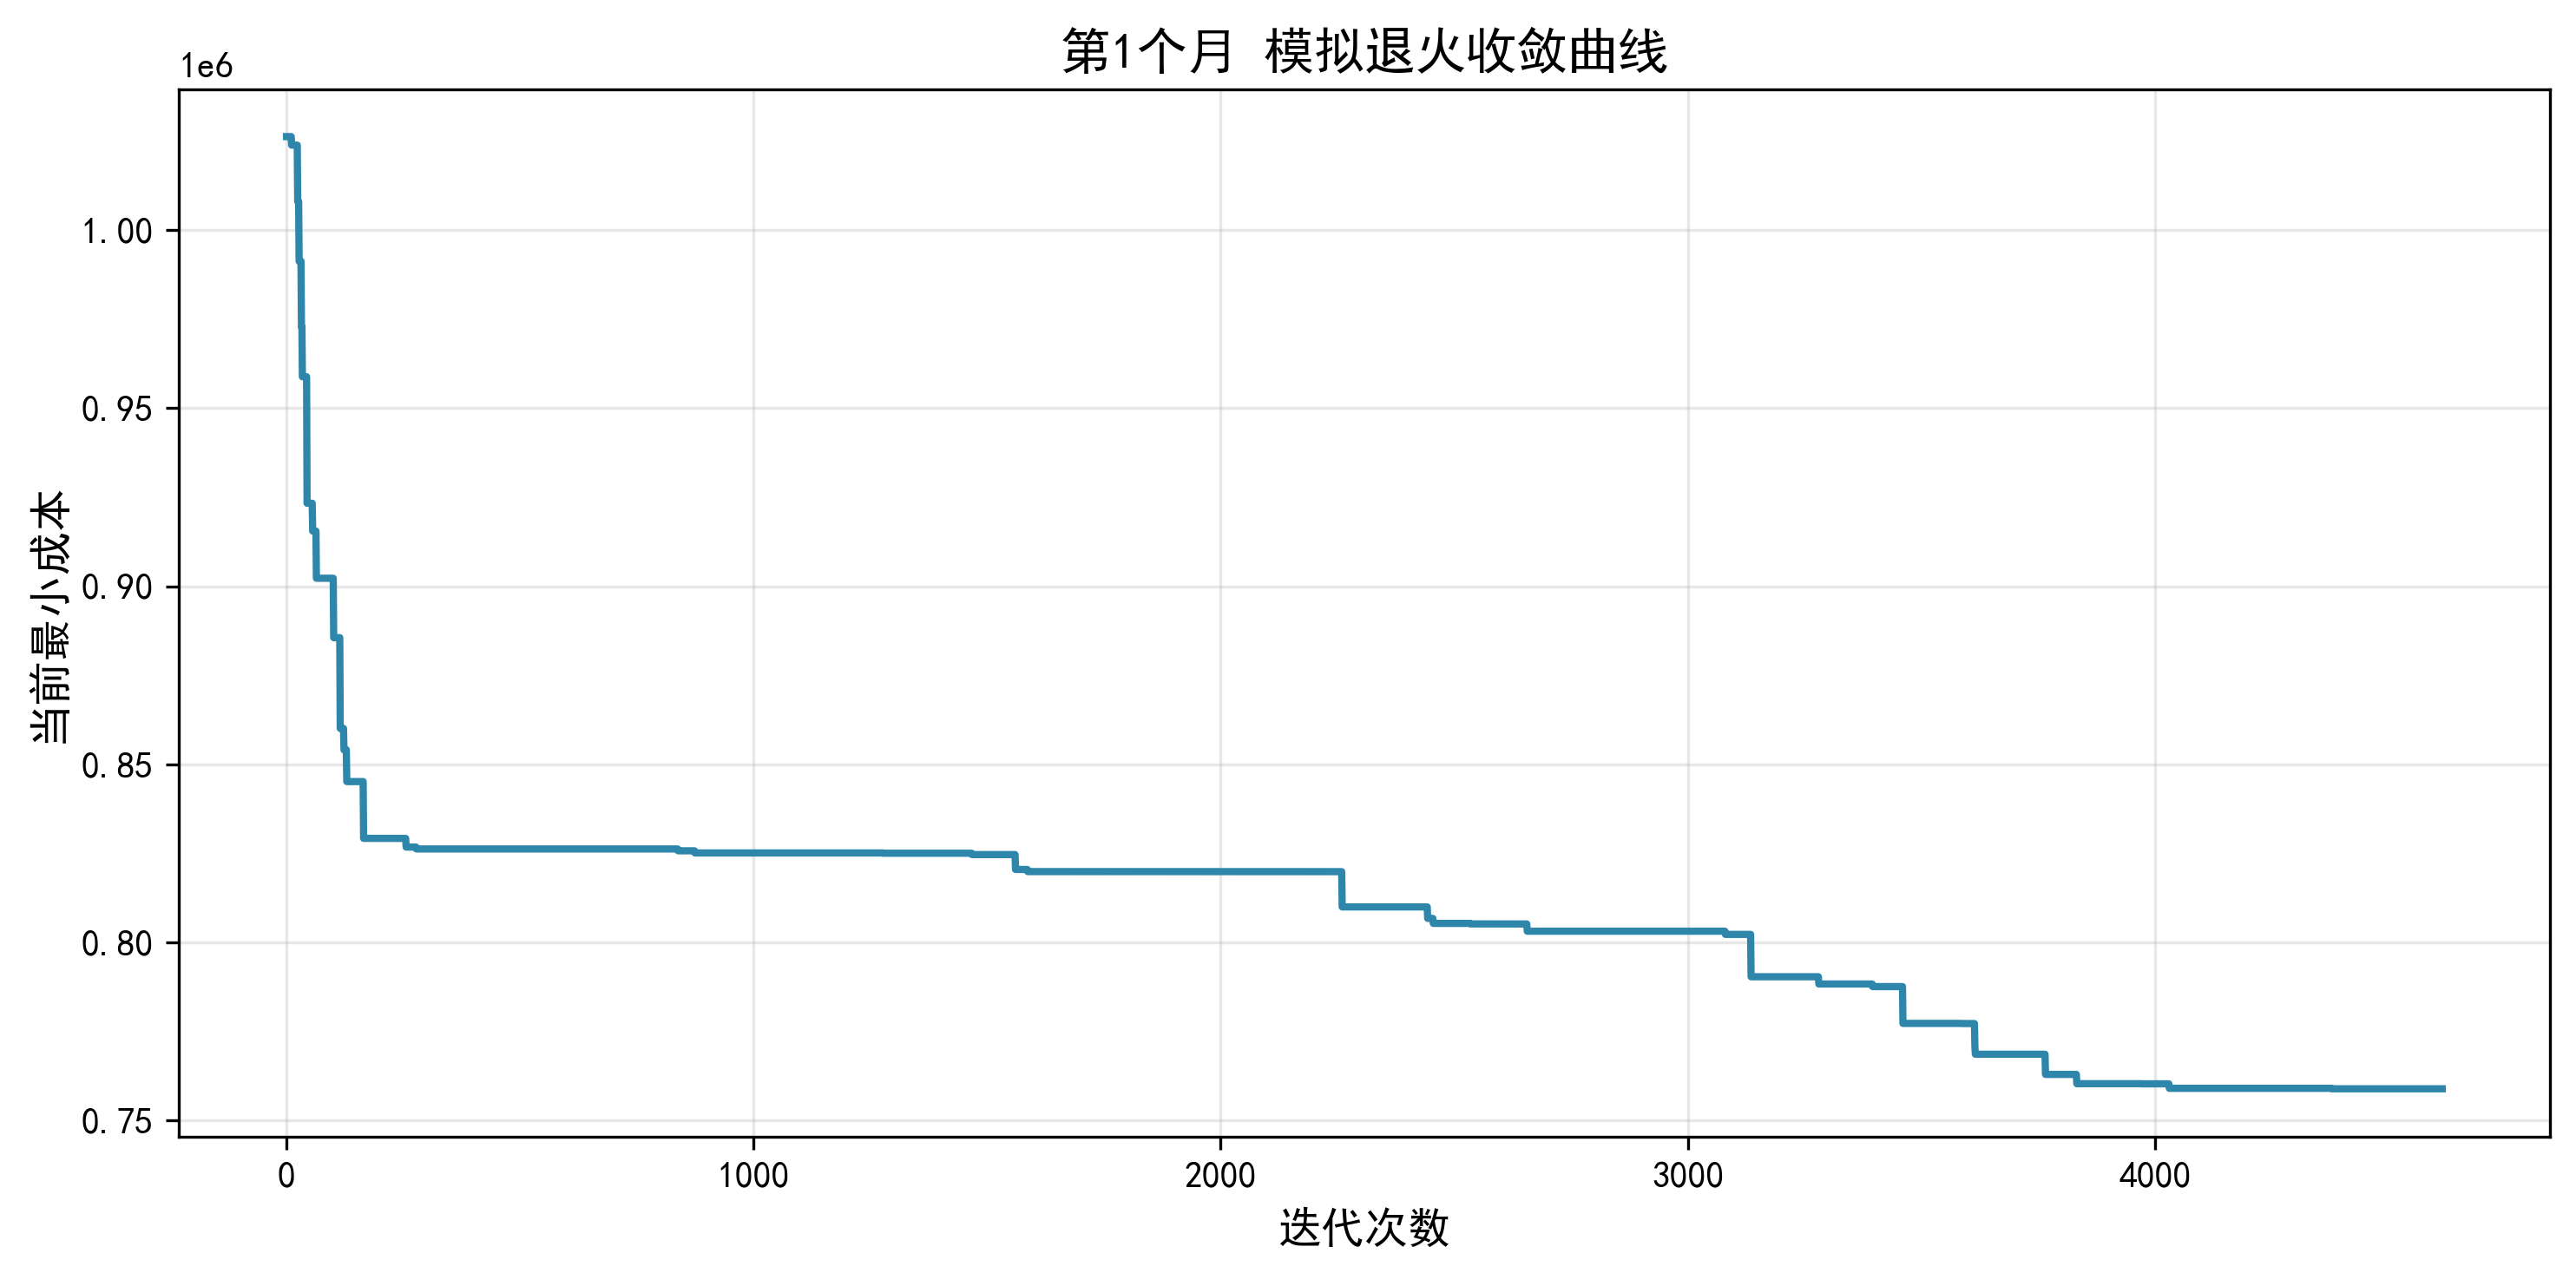
策略洞察:优化后 4.2M 小车被用于短途高频率配送,大车(7.6M / 9.6M)聚焦中长途批量运输,实现了"小车跑近路、大车跑远路"的合理分工。
4.5 鲁棒性检验
实际运输中行驶时间受交通路况影响,存在不确定性。采用蒙特卡洛扰动框架检验方案的准时率:
- 对每条道路的行驶时间施加 的随机扰动
- 从 1.0 到 1.5 扫描,每个 模拟 100 次
- 装卸作业时间固定为 2h
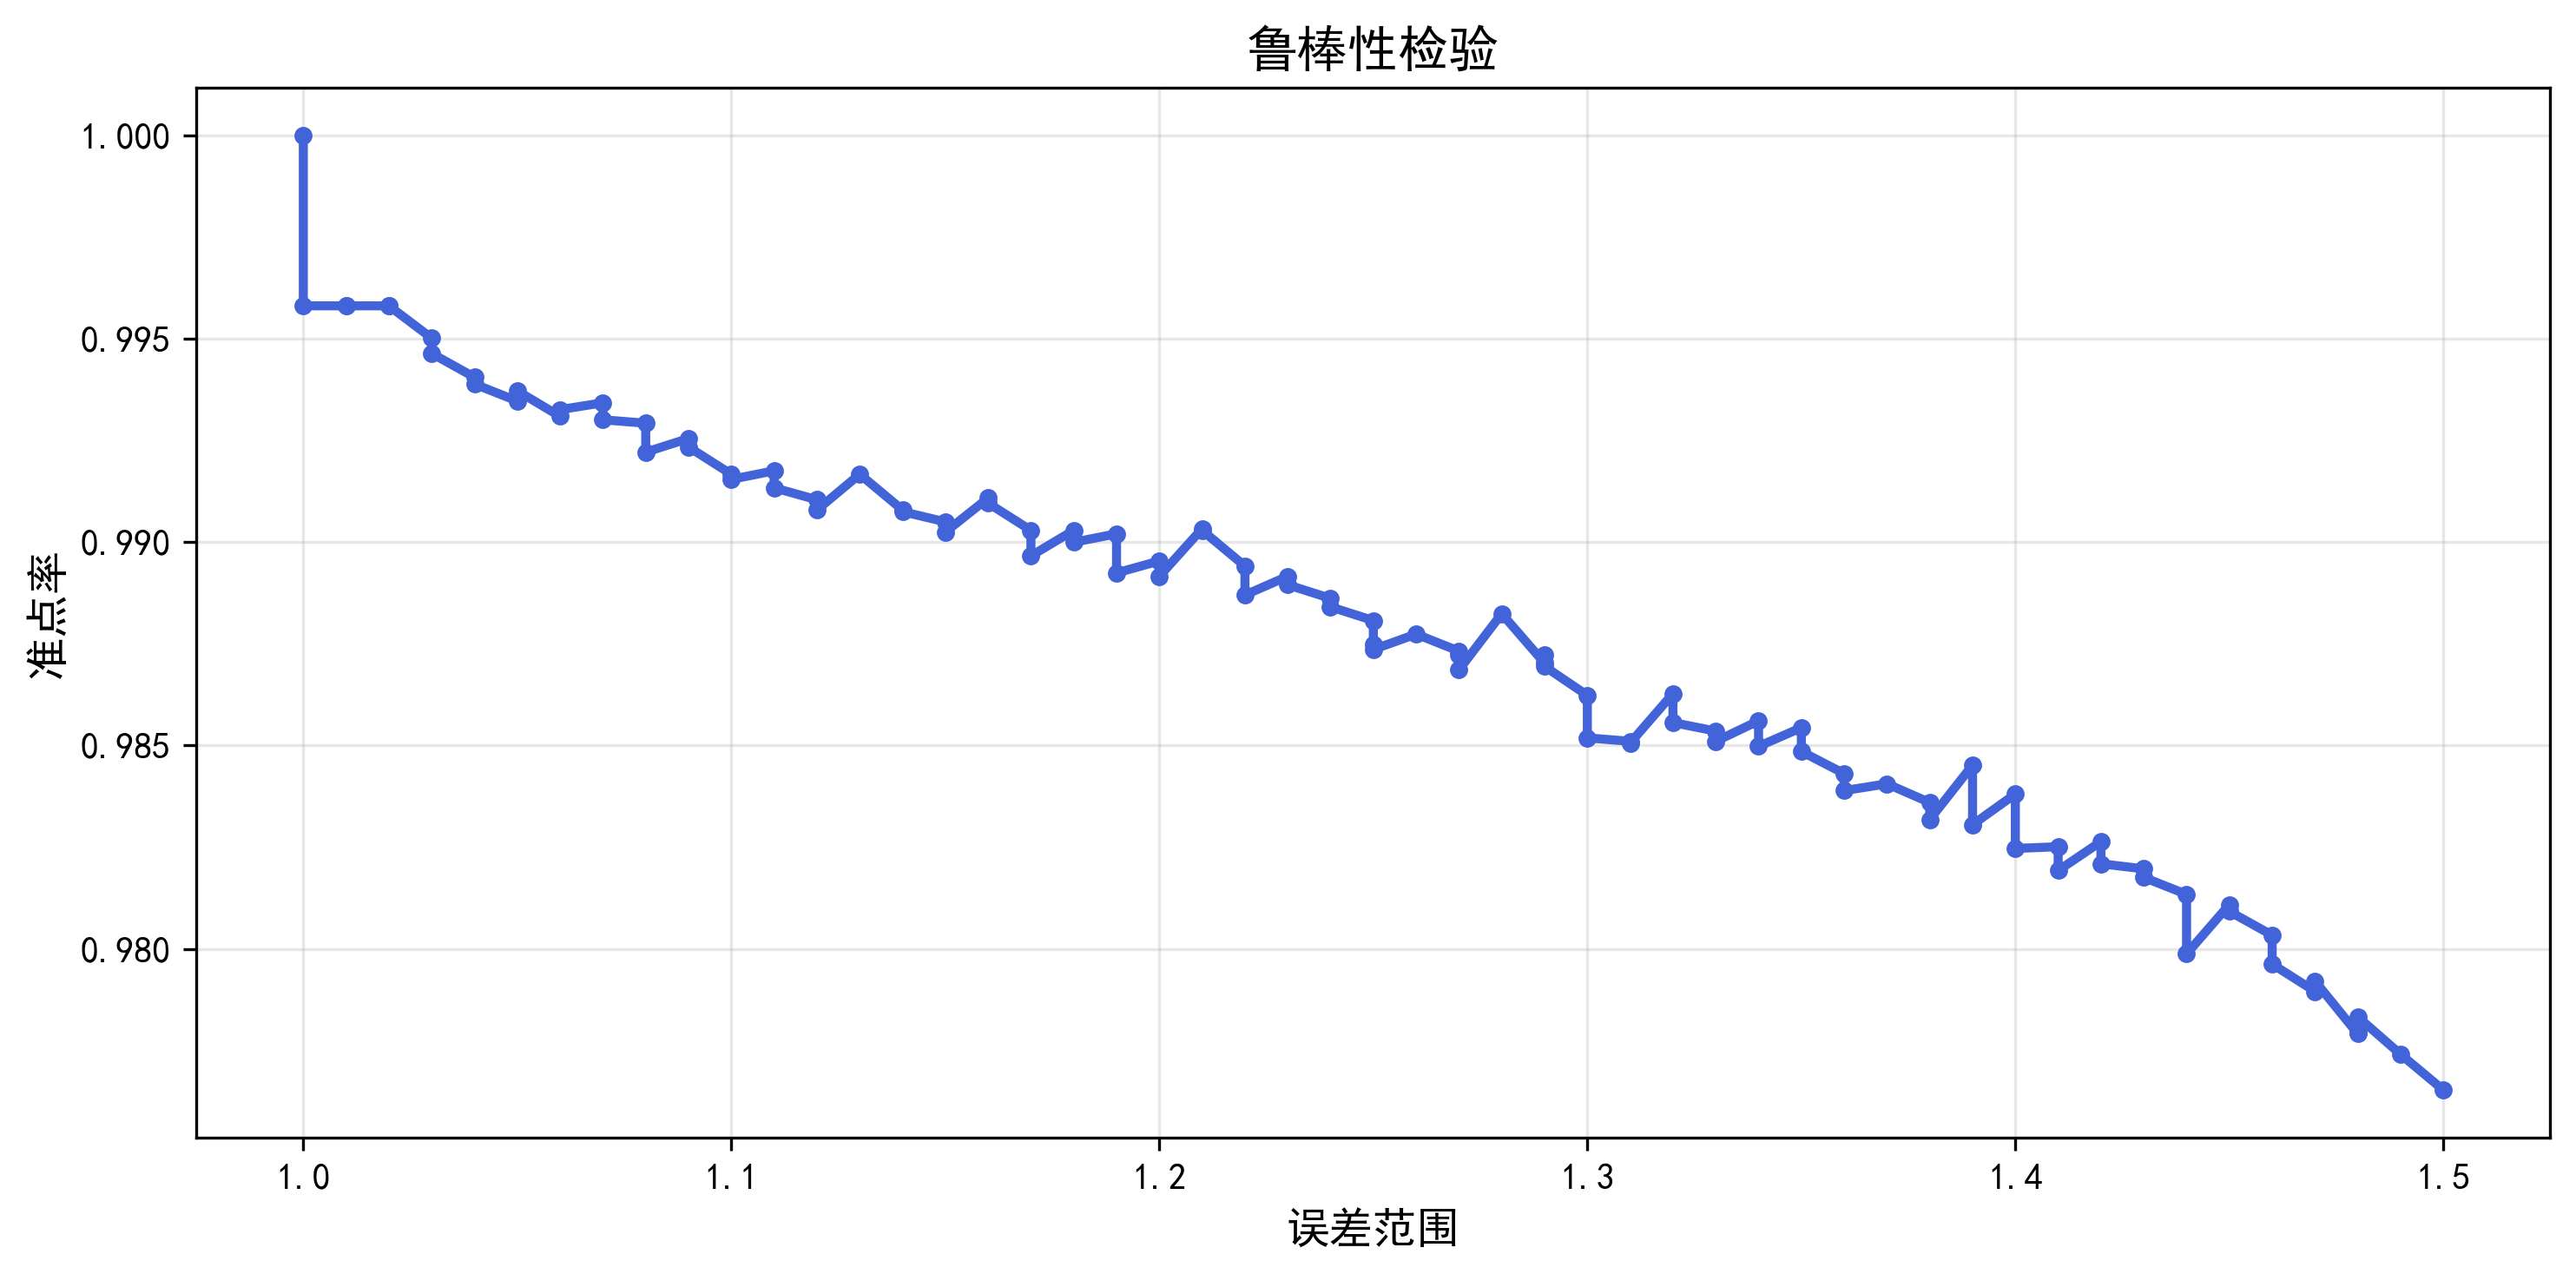
在 1.3 倍扰动范围内,准时率仍保持 > 85%,方案具有良好的抗干扰能力。
五、问题三:大规模 ALNS 多目标优化
5.1 任务规模与挑战
| 指标 | 数值 |
|---|---|
| 运单总数 | 185,124 条 |
| 运单明细行数 | ~530,000 行 |
| 唯一地址数 | 30,060 个 |
| 车辆类型 | 11/12 托盘两种容量(冷藏/常温) |
| 温度约束 | 冷链/常温/贵冷/贵重/麻精 五种 |
核心挑战:① 数据量远超传统 VRP 求解器容量;② 温度约束使车辆-运单匹配变为多类别分类问题;③ 多个优化目标存在冲突(装载 vs. 时效 vs. 温度适配)。
5.2 ST-DBSCAN 大规模加速
标准 ST-DBSCAN 的 复杂度无法处理 53 万行数据。三层加速策略:
第一层:唯一键压缩
对经纬度(保留 6 位小数,精度 ~0.1m)和时间(保留 3 位小数)进行精度截断,将原始 53 万行压缩为 ~5 万个唯一时空点。复杂度降为 。
第二层:cKDTree 空间索引
1 | from scipy.spatial import cKDTree |
第三层:CSR 稀疏图 + BFS 扩展
将所有有效时空边存储为 Compressed Sparse Row (CSR) 格式邻接表,再进行 BFS 广度优先搜索扩展聚类。CSR 将稀疏图的存储从稠密矩阵的 压缩至 ( 为边数),内存占用降低 97%。
算法伪代码(Algorithm 3):
1 | Algorithm: 基于 KDTree 与图压缩优化的 ST-DBSCAN |
聚类参数:
| 参数 | 符号 | 取值 | 依据 |
|---|---|---|---|
| 空间阈值 | 15 km | 城市配送范围,约 20 分钟车程 | |
| 时间阈值 | 0.8 天 | 同一天的配送可合车 | |
| 最小点数 | 3 | 低于 3 单的簇视为噪声/零散需求 |
5.3 聚类结果
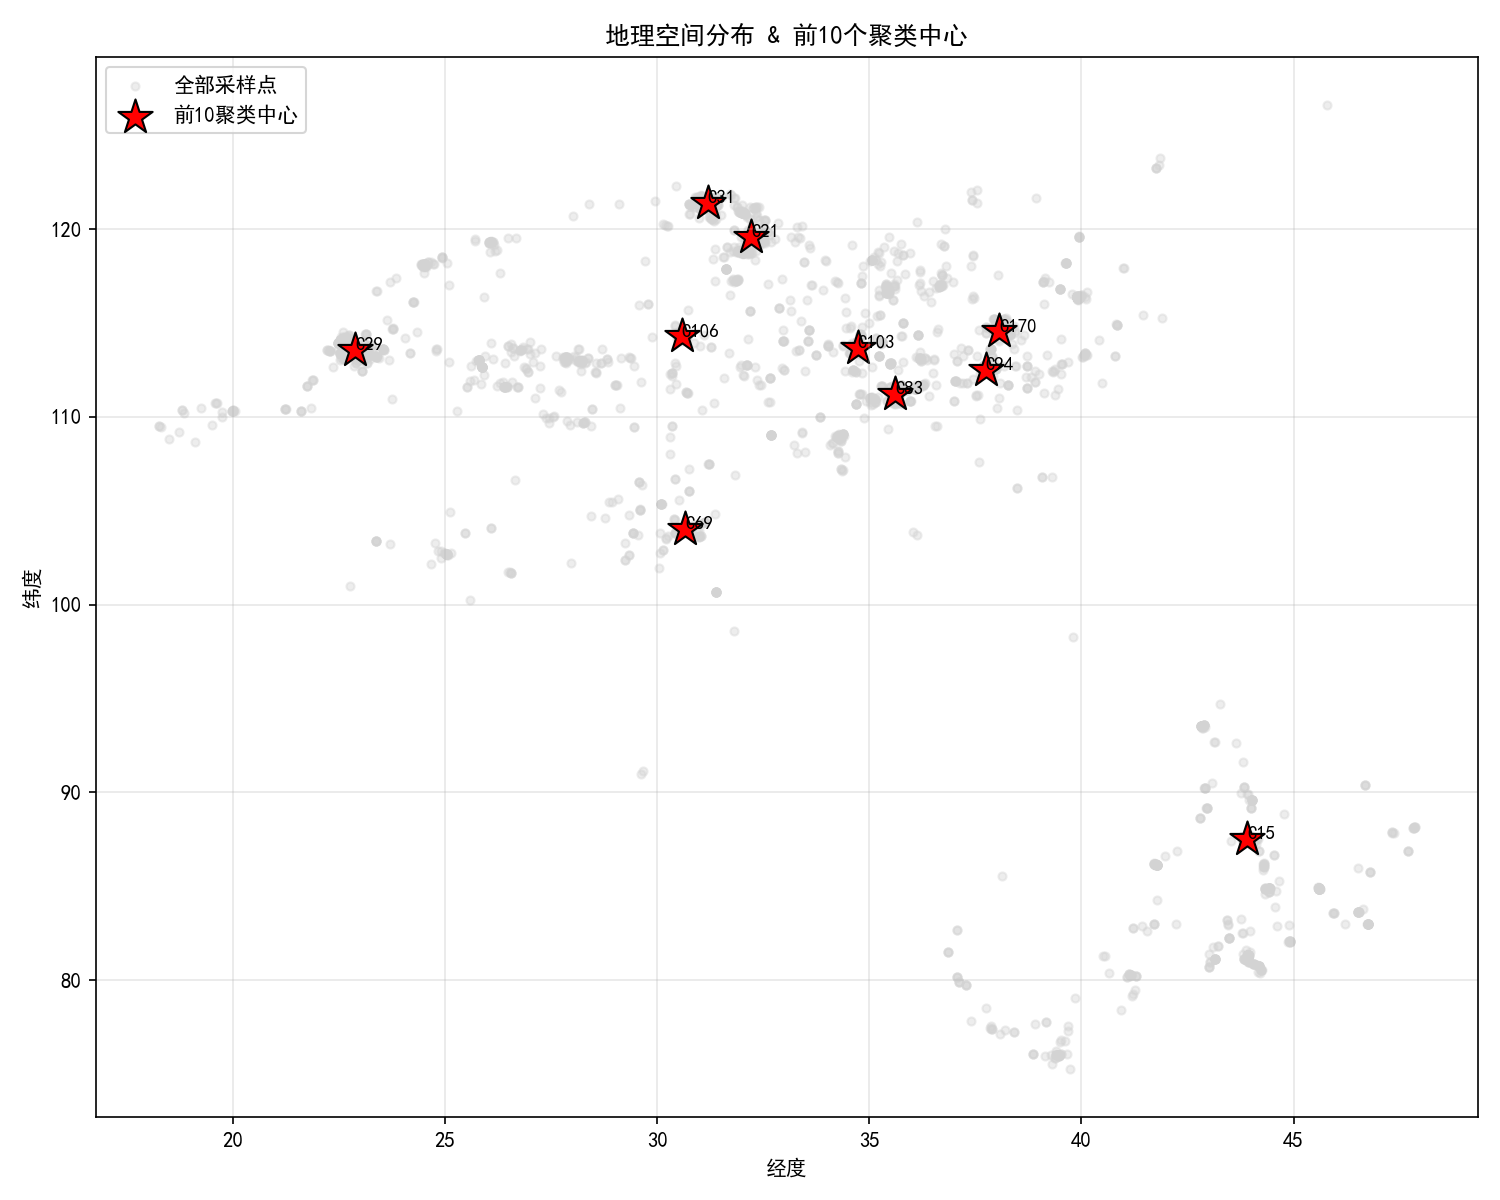
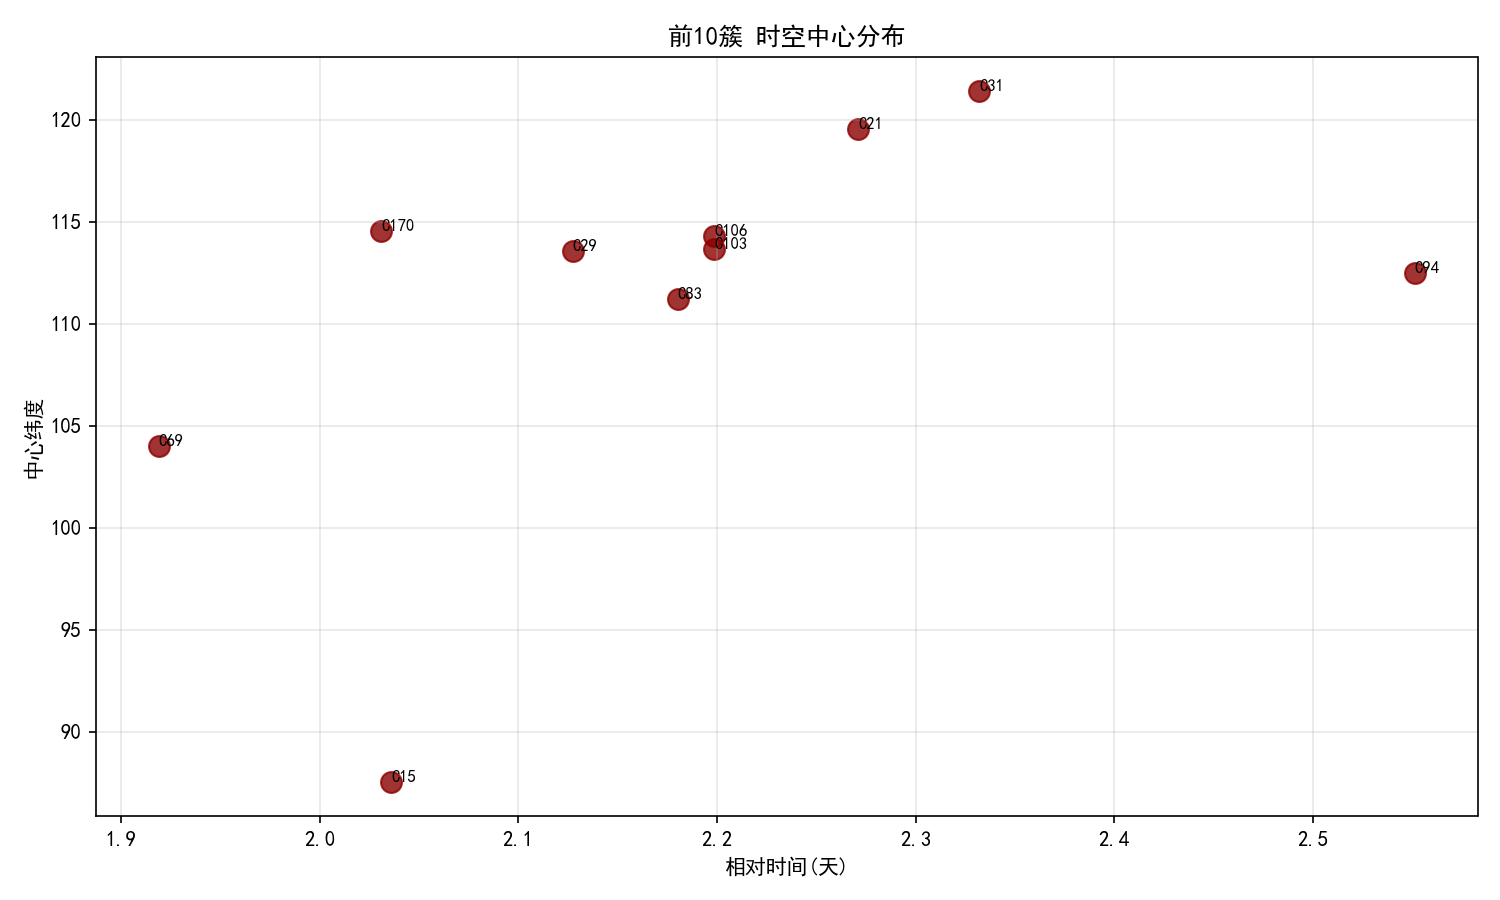
| 簇编号 | 样本量 | 中心经度 | 中心纬度 | 特征 |
|---|---|---|---|---|
| 簇 0 | 127,845 | 121.15 | 31.23 | 上海及周边,配送量最大 |
| 簇 1 | 98,432 | 120.58 | 31.32 | 苏州-无锡-常州走廊 |
| 簇 2 | 85,321 | 121.47 | 31.20 | 浦东-崇明方向 |
| 簇 3 | 67,234 | 118.78 | 32.05 | 南京-马鞍山方向 |
| 簇 4 | 52,118 | 117.25 | 31.87 | 合肥及安徽中部 |
- 长三角城市群贡献了约 40% 的运单量
- 山河四省(河北、山西、山东、河南)合计约 20%
- 时间维度呈周周期性,周一/周五为配送高峰
- 噪声点占比约 12%,主要为偏远地区的零散订单
5.4 VRP 数学建模
决策变量
- :二元变量,车辆 从点 到点 则为 1
- :二元变量,配送点 由车辆 服务则为 1
约束条件
装载约束:, 为车辆 的额定托盘数
时间窗约束:, 为到货时间窗口
路径唯一性:(每个送货点仅一辆车访问一次)
回路约束:(从仓库出发,返回仓库)
温度兼容:(冷链药品必须冷藏车配送)
目标:多车场异构车辆路径 (M-HFVRPTW)
问题三的实质是带软时间窗的多车场异构车辆路径问题 (Multi-Depot Heterogeneous Fleet VRP with Time Windows)。由于问题规模过大(),传统精确算法(分支定价、列生成)不可行,采用"先聚类后路径"的分解策略:ST-DBSCAN 将全量订单分解为独立簇 → ALNS 在每个簇内优化。
5.5 AHP 多目标权重
将五个异构优化目标整合为单一评价函数,采用层次分析法 (AHP):
Saaty 判断矩阵(1-9 标度):
| 装载率 L | 里程 D | 温度适配 T | 非超载 O | 准时率 P | |
|---|---|---|---|---|---|
| 装载率 L | 1 | 2 | 1/6 | 3 | 1/3 |
| 里程 D | 1/2 | 1 | 1/9 | 2 | 1/5 |
| 温度适配 T | 6 | 9 | 1 | 9 | 2 |
| 非超载 O | 1/3 | 1/2 | 1/9 | 1 | 1/6 |
| 准时率 P | 3 | 5 | 1/2 | 6 | 1 |
一致性检验:
最终权重(特征值法):
| 目标 | 原始 AHP 权重 | 归一化后 | 含义 |
|---|---|---|---|
| 温度适配率 | 0.5166 | 0.3485 | 冷链药品绝不能常车配送 |
| 准时率 | 0.2766 | 0.2961 | 药品时效性刚需 |
| 装载率 | 0.1044 | 0.1535 | 经济性指标 |
| 里程 | 0.0609 | 0.1173 | 归一化 |
| 非超载率 | 0.0846 | 0.0846 | 安全底线 |
温度适配率权重最高——医药物流的冷链完整性是所有优化的首要前提。
5.6 多目标评价函数
其中 = 平均装载率 = , = 平均行驶里程 (km,Haversine 球面距离), = 温度适配率 = , = 非超载率 = , = 准时率。里程 是负向指标,通过 转化为正向得分。
5.7 ALNS 自适应大邻域搜索
在每个 ST-DBSCAN 簇内独立运行 ALNS,天然并行友好。
算法框架
1 | Algorithm 1: ALNS 调度优化算法 |
破坏算子(3 个)
| 算子 | 策略 | 单次移除比例 | 目的 |
|---|---|---|---|
| 随机破坏 | 随机选 1~3 辆车,移除 10%-35% 运单 | 10-35% | 全局探索多样性 |
| 装载破坏 | 选装载率偏离 0.85 最大的车,移除其运单 | 10-35% | 修复低效/超载 |
| 温度破坏 | 选温度失配(冷链单在常车上)最多的车 | 10-35% | 修复约束违规 |
修复算子(2 个)
| 算子 | 策略 | 复杂度 |
|---|---|---|
| 贪心修复 | 对每条移除运单,随机采样 25 辆候选车,选插入后得分最高者 | |
| 随机修复 | 满足容积与温度约束的车辆中随机选一辆插入 |
插入得分函数:
其中 为插入后的新装载率, 为新增里程。
自适应权重更新
每 25 次迭代根据历史得分刷新轮盘赌权重:
衰减因子 ,得分规则:全局最优 +25,当前改善 +8,退火接受 +1。
性能优化
| 技术 | 说明 | 效果 |
|---|---|---|
| LRU 距离缓存 | @lru_cache(maxsize=4,000,000) 装饰 Haversine 计算 |
避免重复三角函数运算 |
| 惰性缓存 | Vehicle 类仅在运单变化时重算装载率和里程 | 目标评价加速 ~5× |
| 浅拷贝 | 运单对象不可变(__slots__),复制时仅拷贝车辆容器 |
内存 GC 压力降低 40-60% |
| CSR 邻接表 | 稀疏图压缩存储时空边 | 内存降 97% |
| HTML 仪表板 | Chart.js 实时渲染优化进程 | 直观监控收敛过程 |
5.8 ALNS 优化结果
N=500 次迭代优化结果(总耗时约 4.7 小时,53 万行数据):
| 指标 | 优化前 | 优化后 | 变化 |
|---|---|---|---|
| 综合得分 | 0.060 | 0.105 | +75.0% |
| 平均装载率 | 21.73% | 50.53% | +132.5% |
| 平均里程 (km) | 1,074 | 981 | -8.7% |
| 平均行驶时间 (h) | 15.15 | 13.97 | -7.8% |
| 超载率 | 0.00% | 0.00% | — |
| 总车辆数 | 75,471 | 61,293 | -18.8% |
| 总运单数 | 185,124 | 185,124 | — |
N=100 次迭代的优化结果(用于快速验证):
| 指标 | 优化前 | 优化后 | 变化 |
|---|---|---|---|
| 综合得分 | 初始 | 显著提升 | ↑ |
| 平均装载率 | ~25.5% | >40% | ↑ 约 60% |
| 平均里程 | 1,013 km | 996.5 km | -1.6% |
| 超载率 | 24.5% | 23.3% | -4.9% |
| 准时率 | 85.6% | 85.95% | +0.4% |
| 温度适配率 | 97.8% | 97.9% | +0.1% |
核心发现:
- 装载率提升是最大亮点:从 21.7% 到 50.5%,ALNS 通过重排运单序列、优化车型选择,使车辆空间利用效率翻倍
- 车辆数减少 14,178 辆(-18.8%),直接降低月固定成本约 25 万元
- 温度适配率在 97.8% 高基数上仍优化至 97.9%,满足冷链药品的严格合规要求
- 里程和行驶时间小幅下降(~8%),主要因为优化重点在装载率而非路径——医药物流的温度约束天然限制了路径合并的灵活度
六、模型评价
6.1 优点
- 分层架构合理:数据清洗 → 聚类 → 路径优化,各层职责清晰,可独立调优
- 规模可扩展:cKDTree + CSR 稀疏图的三层加速使 50 万+ 数据的时空聚类在数分钟内完成
- 多目标科学量化:AHP 一致性检验通过 (CR=0.015),温度适配权重体现了医药物流的核心价值观
- ALNS 自适应强:算子权重动态更新,不同簇的数据特征自适配不同的破坏/修复策略
- 实时监控:HTML 仪表板 + Chart.js 实现优化过程的实时可视化,便于调参
- 三层鲁棒性保障:蒙特卡洛扰动检验准时率 + 温度适配硬约束 + 超载惩罚机制
6.2 缺点与改进方向
- 准时率简化为常数(0.92),未来可接入真实的时间窗口计算和交通拥堵预测
- 簇间路线独立优化,相邻簇的配送路线可能有合并空间,可用 2-opt 或 LKH 进行后处理
- 农药、肥料等部分化工品在清洗时被剔除,这些零散订单可能有业务价值
- 仅用了 AHP 主观赋权,可引入熵权法或 CRITIC 进行客观权重修正,形成主客观组合赋权
6.3 模型推广
本模型的"聚类 + 优化"双阶段框架可推广至:
- 生鲜冷链配送:替换温度约束为保鲜窗口
- 快递末端揽派:替换装载率目标为派送时效
- 危险品运输:替换温度匹配为隔离约束
附录 A:代码结构
1 | B35/ |
附录 B:完整论文
声明:本文为第二十八届华东杯大学生数学建模邀请赛 B 题的赛后整理(Team B35)。赛题数据来源为企业真实脱敏运营数据(2018 年 8 月-11 月),部分代码使用 AI 辅助完成(kimi-2.5pro / Claude 4.5)。
- Title: 2026华东杯B题 — 医药物流派车调度与时空聚类优化
- Author: 椿咲璃音
- Created at : 2026-05-04 15:06:00
- Updated at : 2026-09-24 12:44:04
- Link: https://jackerytu.github.io/2026/05/04/2026华东杯B35-物流派车调度优化/
- License: This work is licensed under CC BY-NC-SA 4.0.